Совладелец рекламного агенства “Ковалевы”
 Тунец
Как попасть в ответы нейросетей: 7 контент-элементов, которые повышают цитируемость
235
06.03.2026
Современные поисковые системы и ассистенты формируют ответы на запросы пользователей через анализ контента с помощью языковых моделей. Попадание фрагментов сайта в такие ответы напрямую влияет на видимость бренда и привлечение целевого трафика. Основной фактор успеха – создание контента, который нейросети распознают как авторитетный источник и цитируют в своих выводах.
В статье – ответы на вопросы, какие элементы повышают вероятность цитирования, как оформлять блоки под интент, какие формулировки чаще попадают в ответы LLM, какие ошибки делают контент «псевдоэкспертным» и какую роль в процессе создания контента играет сервис Тунец.
Зачем попадать в ответы нейросетей
Компания Gartner еще два года назад сделала прогноз, что к 2026 году объем запросов в традиционных поисковых системах снизится на 25%, а поисковый маркетинг потеряет долю рынка в пользу чат-ботов на основе ИИ и других виртуальных агентов. Сегодня можно наблюдать, что традиционная поисковая выдача уступает место синтезированным ответам, формируемым языковыми моделями. Это подтверждают данные отчета Digital Content Next.
В 2025 году поиск в Google и Яндексе перешел к формату встроенных генеративных ответов. Вместо списка ссылок пользователю все чаще показывается готовый структурированный ответ на базе Gemini 3 и Алисы AI. Ответы языковых моделей уже присутствуют почти в половине коммерческих запросов и в большинстве информационных, поэтому оптимизация смещается от борьбы за клики к попаданию в сами ответы.
Согласно исследованию Ahrefs за январь 2026 года, платформы ИИ по-прежнему набирают обороты: Gemini лидирует с ростом на 53,1%. Показатели ChatGPT растут (на 9,2%), Claude – на 20,7%, и только доля Perplexity (-13,8%) продолжает снижаться. Доля поиска с использованием искусственного интеллекта в общем трафике составляет 0,23%. На фоне всплеска использования искусственного интеллекта традиционные поисковые системы пока остаются стабильными.
Цитируемость становится новым эквивалентом топовой позиции в классическом поиске. Если ранее видимость определялась местом в результатах выдачи, сегодня ключевой метрикой выступает присутствие бренда в источниках, на которые опираются языковые модели при генерации ответов.
Какие принципы контента определяют цитируемость в 2026 году
Для языковых моделей решающим становится не количество символов в статье и частота ключевых слов, а практическая полезность каждого фрагмента. Приоритет получают короткие блоки, которые содержат уникальную экспертную информацию.
Выбор источников опирается на признаки E-E-A-T, но в прикладном виде: наличие ссылок на первоисточники и исследования, актуальной статистики и кейсов с измеримым результатом.
Структура текста имеет важное значение. Логическая иерархия заголовков, четкое членение на смысловые блоки и наличие самодостаточных абзацев позволяют модели легко извлекать релевантные фрагменты без потери контекста. Чтобы такие фрагменты попадали в нейровыдачу, прямой ответ на вопрос пользователя должен находиться в начале раздела.
Ключевые признаки цитируемого фрагмента:
- одна мысль в одном абзаце;
- отсутствие местоимений и ссылок на внешний контекст;
- явный объект, действие и результат;
- отсутствие оценочных формулировок без критериев;
- отсутствие рекламных или субъективных конструкций.
Какие контент-элементы чаще всего цитируют нейросети
Анализ ответов ведущих моделей, включая ChatGPT, Perplexity и Gemini, показывает устойчивую закономерность: LLM анализируют не объемные рассуждения, а компактные блоки с четкой структурой. Ниже приведены элементы, которые стабильно показывают наибольшую пригодность для включения в генеративные ответы.
1. Определения терминов и глоссарии
Определения используются моделями при ответах на запросы формата «что такое», «что это». Они должны быть формализованы и содержать прямой ответ.
Пример цитируемого фрагмента:
«GEO-оптимизация – это комплекс работ по оптимизации сайта под алгоритмы генеративных систем искусственного интеллекта».
Нейросети лучше воспринимают определения, которые:
- не содержат эмоциональной окраски;
- не используют образные формулировки и метафоры;
- не включают примеры внутрь определения;
- не ссылаются на внешний контекст.
Рекомендуемая модель: термин + это + категория + назначение или эффект. Такие блоки легко извлекаются LLM как автономная смысловая единица.
2. Структурированные списки признаков и этапов
Структурированные списки преобразуют разрозненную информацию в последовательность проверяемых фактов. Нейросети предпочитают нумерованные или маркированные перечни, где каждый пункт представляет собой законченную мысль.
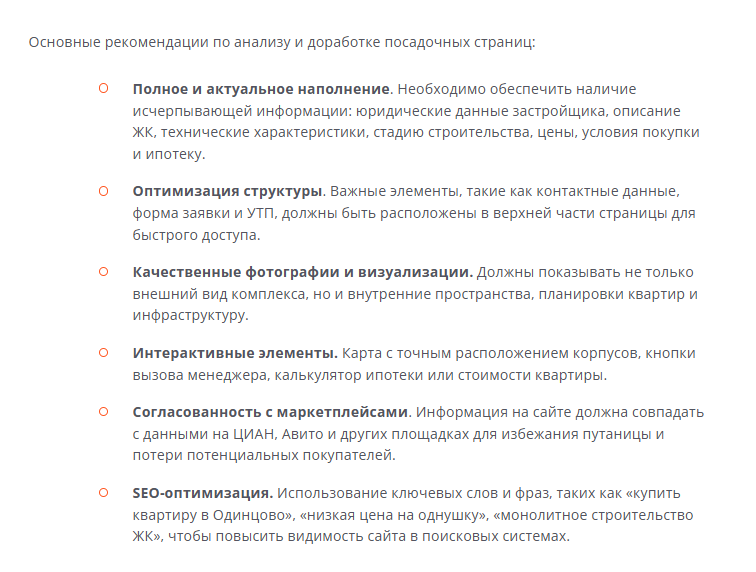
Пример структурированного списка
Наиболее часто цитируются списки, в которых:
- каждый пункт описывает только один признак, этап или условие;
- отсутствуют объединенные формулировки и перечисления внутри одного пункта;
- используются конкретные параметры, например сроки, цифры, наименования.
Практика GEO показывает, что списки признаков, этапов или требований часто используются Perplexity при формировании справочных ответов.
3. FAQ-блоки
Формат «вопрос плюс короткий ответ» максимально совпадает с логикой генерации ответа LLM.
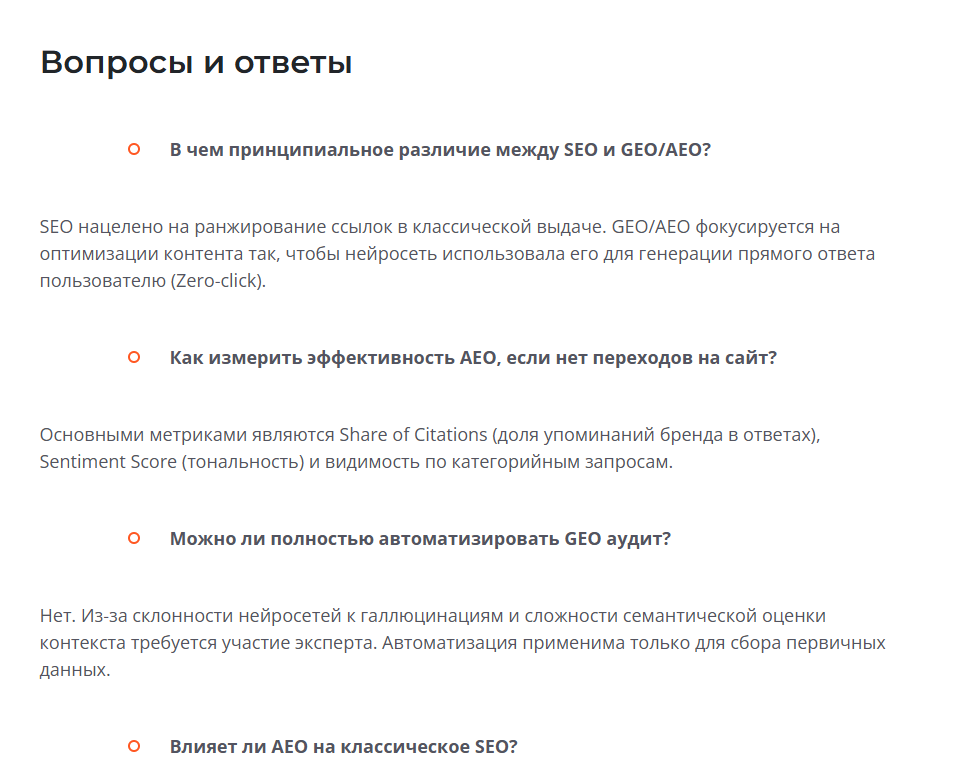
Оформление FAQ-блока
Рекомендации по оформлению:
- один вопрос один ответ;
- ответ не превышает двух абзацев;
- не используются вводные фразы («как уже говорилось выше» и т.п.);
- формулировки в вопросах максимально приближены к реальным запросам («как попасть в ответы нейросетей», «чем GEO отличается от SEO» и т.п.);
- информация должна быть уникальной, точной, экспертной.
FAQ активно используются как основной источник для «быстрых ответов» и сниппетов.
4. Таблицы и структурированные сравнения с характеристиками
Нейросети могут анализировать фрагменты таблиц, когда им нужно показать отличие вариантов, критерии или плюсы‑минусы. Таблицы – это компактно и структурно.
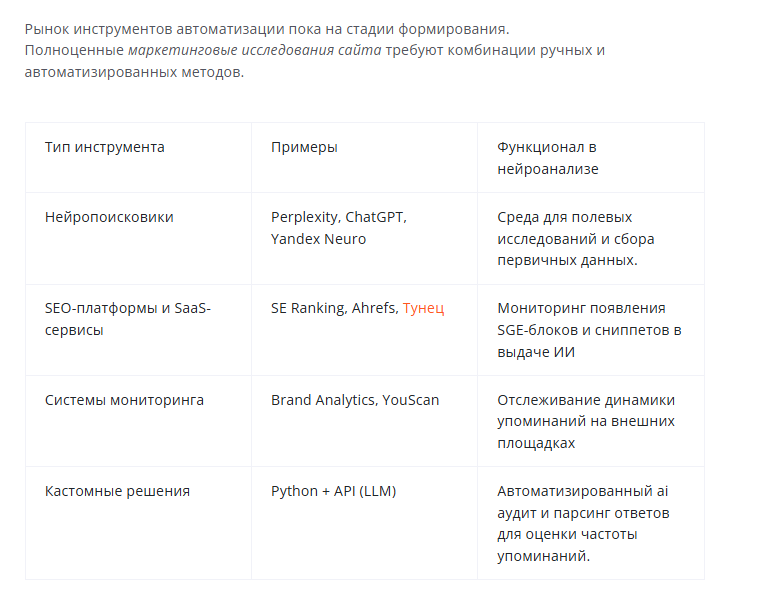
Формат таблицы в теле статьи
Лучше всего работают:
- сравнительные таблицы (например, «SEO vs AEO vs GEO» с колонками «цель», «метрики», «формат контента»);
- таблицы критериев выбора (параметр, рекомендуемое значение, влияние);
- таблицы с цифрами и диапазонами (сроки, проценты, бюджетные вилки).
Табличные форматы активно используются нейросетями при ответах на запросы «чем отличается», «что лучше», «сравни». Наиболее пригодными для цитирования являются таблицы, где строки и столбцы построены по единым критериям, отсутствуют разнородные параметры в одной ячейке, а также используются формализованные признаки, а не описательные абзацы.
5. Пошаговые инструкции/практические рекомендации
Алгоритм должен описывать последовательность действий без вариантов и развилок.
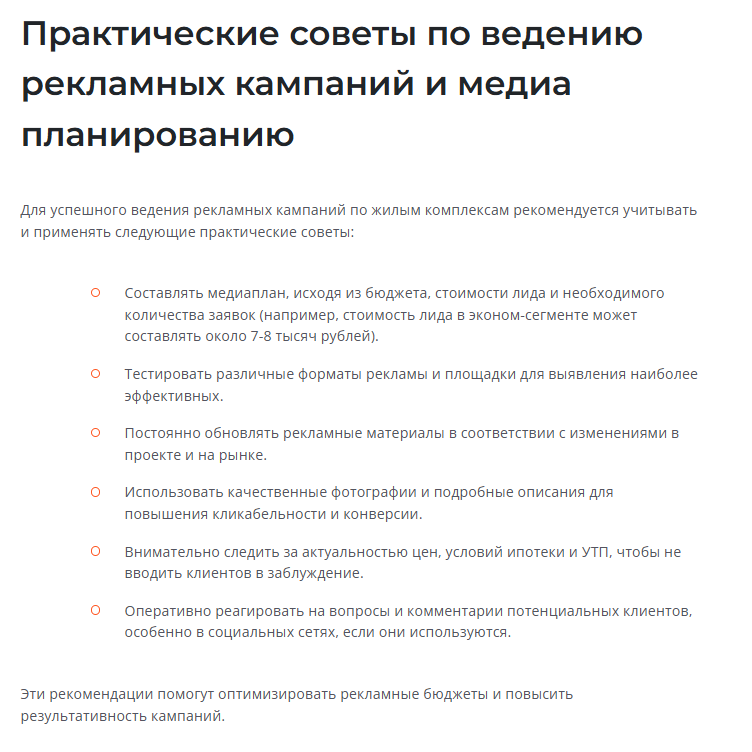
Пример пошаговой инструкции для достижения результата
Классическая форма: Шаг 1. Действие ⭢ Шаг 2. Действие ⭢… Шаг N. Результат.
Снижают вероятность цитирования:
- несколько условий в одном шаге («если…, а также если…»);
- размытые формулировки «при необходимости», «по возможности»;
- отсутствие явного целевого результата в конце процедуры.
Алгоритмы особенно полезны в темах «как подготовить…», «как настроить…», «как выбрать…» и т.д.
6. Кейсы
В нейроответы попадают упоминания кейсов с понятным входом, действиями и измеримым результатом.
Хороший кейс для цитирования содержит:
- исходную точку (ситуация до начала работ);
- набор предпринятых шагов (кратко, структурно);
- измеримый результат
Кейсы с цифрами подкрепляют утверждения измеримыми результатами. Упоминание конкретных метрик повышает доверие модели к источнику. Например, рост трафика на 37 процентов за два месяца, увеличение цитируемости на 22 позиции. Цифры выступают как верифицируемые точки опоры в процессе генерации ответа.
7. Указание эксперта
Оформленный блок с информацией об эксперте повышает доверие языковых моделей к источнику и усиливает признаки E-E-A-T.
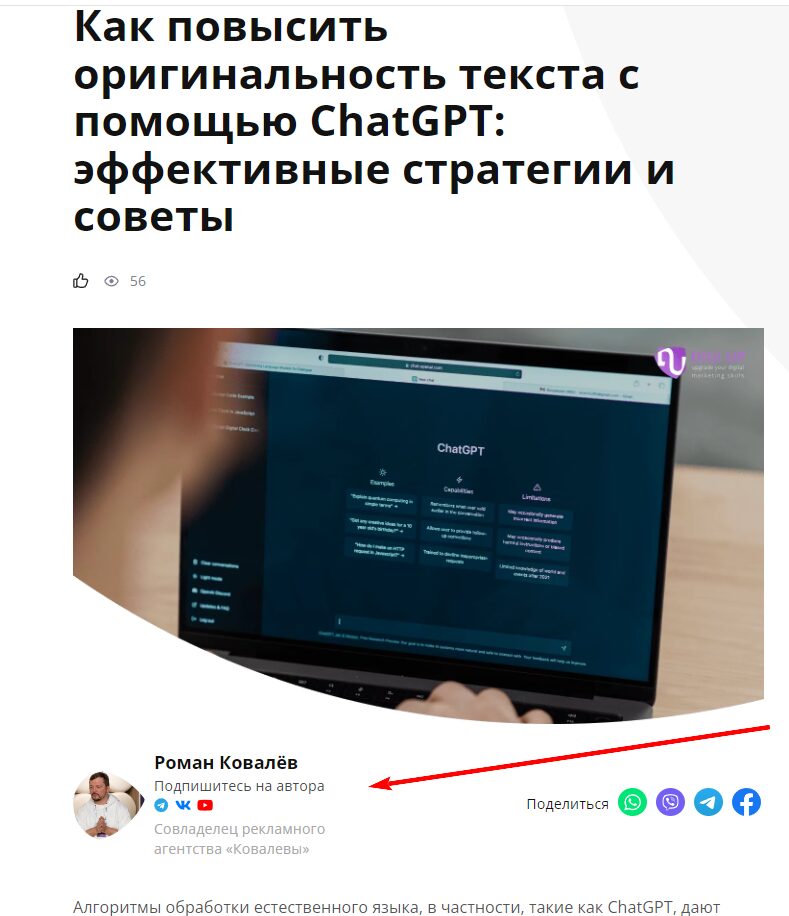
Пример оформления блока эксперта
Для генеративных систем важно не просто наличие автора на странице, а возможность связать контент с конкретным специалистом и его предметной областью.
Цитируемым считается не подпись под статьей, а отдельный структурированный фрагмент, в котором зафиксированы:
- имя и фамилия специалиста;
- профессиональная роль или должность;
- предметная область экспертизы;
- практический опыт, релевантный теме материала;
- подтверждаемые источники профессиональной деятельности.
Такой блок должен быть визуально и логически отделен от основного текста.
Для задач GEO/AEO очень важно, чтобы область экспертизы совпадала с темой конкретного материала, опыт был описан через виды работ или проекты, а не через общие формулировки, подтверждения вели на внешние или внутренние страницы с достоверной информацией.
Как оформлять блоки под интент и проверяемость
Весь контент должен удовлетворять информационный интент запроса и содержать верифицируемые данные. Интент определяет форму подачи – для запросов «что такое» подходит определение, для «как» – алгоритм, для «сравнить» – таблица различий.
Проверяемость достигается через привязку к авторитетным источникам: нормативным актам с указанием номера и даты, исследованиям с ссылкой на организацию-исполнителя, статистике с указанием периода сбора данных и т.д.
Статья должна быть построена как последовательность самостоятельных ответов на разные пользовательские интенты.
Практическая структура:
- отдельный H2 для каждого интента;
- внутри блока явный вопрос;
- сразу после вопроса прямой ответ;
- далее уточнение или расширение.
Структура блока должна позволять извлечение необходимой информации без потери смысла. Каждый абзац или пункт списка должен быть точно сформулирован, содержать решение, опираться на факты. Стоит избегать отсылок к предыдущему контексту вроде «как указано выше» или «этот метод» без конкретизации.
Какие ошибки снижают цитируемость контента
Распространенная ошибка – псевдоэкспертность, проявляющаяся в избыточном использовании профессионального жаргона без пояснений или в поверхностном упоминании сложных концепций. Нейросети распознают несоответствие между заявленной глубиной анализа и фактическим содержанием, что снижает доверие к источнику.
Другая типичная проблема – размытые формулировки с обобщающими местоимениями и отсутствием конкретики. Фразы вроде «многие специалисты считают» или «в ряде случаев возможно» не предоставляют модели опорных точек для генерации точного ответа. Такие блоки игнорируются в пользу более определенных источников.
Оформление длинных абзацев без визуального членения также препятствует цитированию. Нейросети анализируют текст на уровне предложений и коротких блоков. Абзац объемом более пяти строк редко цитируется целиком, а его фрагменты теряют смысловую целостность при извлечении.
Какую роль играет сервис Тунец в повышении цитируемости
Сервис Тунец проверяет, появляется ли домен и отдельные фрагменты контента сайта в ответах популярных языковых моделей по конкретным запросам. Таким образом инструмент помогает понять, видят ли нейросети контент и используют ли его, когда формируют ответы пользователям.
Зачем это нужно на практике:
- можно увидеть, какие форматы и формулировки текста нейросети охотнее подхватывают;
- можно находить темы и запросы, где контент есть, но он не подходит под логику генеративного поиска;
- на этой основе дорабатывать тексты так, чтобы они чаще использовались нейросетями в ответах.
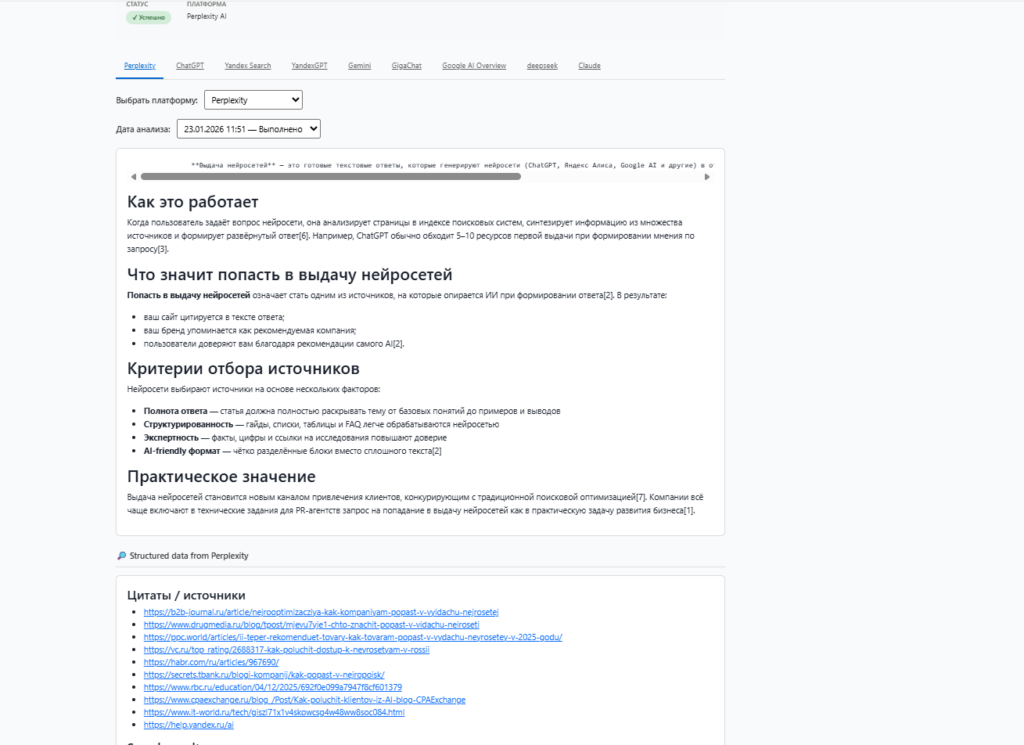
Пример ответа в Perplexity с указанием источников
Данные из Тунца дополняют традиционную веб-аналитику, добавляя измерение видимости в среде нейросетевых ассистентов. Регулярный мониторинг позволяет корректировать контент-план с учетом изменений в алгоритмах генерации ответов и предпочтениях моделей при выборе источников.
Кроме того, в сервисе можно сгенерировать готовое ТЗ с учетом всех параметров цитируемости LLM для некоторых моделей.
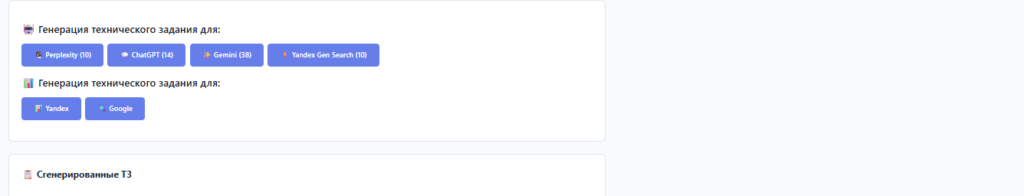
На данный момент генерация технического задания доступна для Perplexity, ChatGPT, Gemini и Yandex Gen Search
Система учитывает:
- типы контент-элементов (определения, алгоритмы, кейсы, таблицы, FAQ, блоки эксперта, критерии выбора);
- структуру текста под интенты и логику извлечения нейросетями;
- проверяемость фактов и наличие ссылок на первоисточники;
- форматы подачи числовых данных и метрик;
- логическую завершенность и автономность смысловых блоков.
Таким образом, сервис Тунец позволяет сразу получить ТЗ, в котором каждый блок спроектирован под генеративные ответы. В результате создается не просто список задач для копирайтера, а готовый каркас контента, который соответствует требованиям E-E-A-T и пригоден для прямого включения в ответы ChatGPT, Perplexity, Gemini и других LLM.
Автоматизация подготовки ТЗ ускоряет процесс создания цитируемого контента в рамках контент-команды и сокращает время на согласование требований между маркетологами, копирайтерами и редакторами. При этом ни один сервис и ни одна система генерации требований не заменяют предметную экспертизу: именно специалист по теме определяет корректность фактов, глубину анализа и практическую ценность материала для пользователя.
В задачах GEO и AEO инструменты автоматизации должны рассматриваться как способ стандартизировать структуру и требования к цитируемости, а не как источник смысла и профессиональных выводов. Устойчивое присутствие в ответах нейросетей формируется только там, где техническая подготовка контента сочетается с реальной отраслевой экспертизой.
Вопросы-ответы
Что важнее для цитируемости: глубина раскрытия темы или структура текста?
Оба фактора критически важны и взаимосвязаны. Глубина раскрытия обеспечивает экспертность и авторитетность источника, а структура определяет машинную читаемость и возможность извлечения фрагментов без потери смысла. Оптимальный результат достигается при сочетании глубокой проработки темы и четкого оформления информации в самодостаточные блоки.
Как проверить, цитирует ли нейросеть конкретный сайт?
Для ручной проверки достаточно задать релевантный вопрос в интерфейсе ведущих платформ – ChatGPT, Perplexity, Яндекс Алиса или Gemini – и проанализировать источники в ответе. Специализированные сервисы вроде Тунца автоматизируют этот процесс, отслеживая упоминания домена и фрагментов контента в ответах нейросетей по заданным запросам и предоставляя динамику цитируемости во времени.
Как часто нужно обновлять контент?
Нейросети опираются на свежие данные. Контент следует обновлять при изменении инструментов, методик, статистики или рыночных условий, особенно если материал содержит сравнительные данные и кейсы. В среднем, рекомендуется актуализировать информацию не реже одного раза в 12 месяцев. Для быстро меняющихся отраслей (финансы, ИТ и т.д.) оптимальная периодичность обновления – раз в 6 месяцев.
Какие технические элементы страницы влияют на пригодность контента для нейросетей?
Для хорошей индексации в целом важны общие требования SEO: высокая скорость загрузки сайта, его стабильная работа, корректность robots.txt. Для GEO/AEO-оптимизации каждая страница должна содержать автономные блоки, корректную разметку таблиц и списков, структуру заголовков, а также наличие вспомогательных навигационных элементов.
Как поддерживать актуальность и экспертность контента в долгосрочной перспективе?
Необходимо регулярно пересматривать ключевые блоки, обновлять источники, дополнять кейсы новыми результатами и сохранять привязку материалов к реальной практике и профессиональной экспертизе.
Вам также будет интересно
LLMEO, AIO, AEO и GEO-продвижение: что это такое и в чем отличия подходов к оптимизации
Меня зовут Роман Ковалев, я сооснователь РА «Ковалевы». Мы занимаемся SEO-, GEO- и AEO-продвижением проектов и помогаем брендам усиливать присутствие в AI-поиске. Последние пару лет AI-системы постепенно меняют саму модель поиска: все больше запросов пользователи закрывают напрямую через ChatGPT, Perplexity, Google AI Overviews, Яндекс Нейро и другие нейросети — без перехода к классической выдаче. Из-за […]
Как AI-поиск меняет правила SEO-оптимизации для интернет-магазинов
Классическая модель SEO для интернет-магазинов строилась вокруг позиции сайта в поисковой выдаче: пользователь вводит запрос → получает список страниц → сравнивает предложения. AI-поиск меняет эту логику. Все чаще пользователь получает готовую интерпретацию запроса и список рекомендованных вариантов прямо в ответе генеративной системы. Поэтому интернет-магазинам становится важно не только занимать позиции в поиске, но и попадать […]
Как правильно обновлять старые статьи, чтобы они снова приносили трафик (и попадали в ответы AI)
Старые статьи часто теряют трафик не потому, что тема перестала быть актуальной, а потому что меняется способ поиска информации. Пользователи все чаще получают ответы напрямую – в поисковых блоках, AI-ассистентах и генеративных системах. Чтобы вернуть трафик, недостаточно просто «освежить текст». Важно перестроить статью так, чтобы она: Ниже – практический разбор: какие статьи стоит обновлять, какие […]
Как Claude выбирает формулировки и источники: практики для снижения искажений и повышения точности упоминаний
Claude устроен иначе, чем системы с явной ссылочной моделью. Он может не показывать источники прямо, но при этом активно воспроизводит формулировки, логические конструкции и интерпретации, которые считает устойчивыми и внутренне непротиворечивыми. Поэтому задача бренда в среде Claude – не только добиться упоминания, но и снизить вероятность смысловых и фактических искажений: подмены категории, расширения трактовки, смешения […]
AEO, SEO и GEO: KPI и результаты – как выстроить цели и измерения по каналам
Смешивать SEO, AEO и GEO в одну общую метрику успеха – частая причина разочарований: каналы работают на разных поверхностях и дают разные типы результата. В классическом SEO оптимизация направлена на рост видимости и переходов из органической выдачи. AEO (Answer Engine Optimization) – на попадание в ответные блоки и виджеты, которые часто закрывают запрос прямо в […]